一個執行數小時的編碼代理程式,每次呼叫工具後,都得讓模型處理新增的輸入。上下文持續累積,真正要生成的 token 卻可能只占少數。模型除了計算,還得保存先前的注意力狀態,供後續請求重複使用。這些狀態就是 KV 快取。
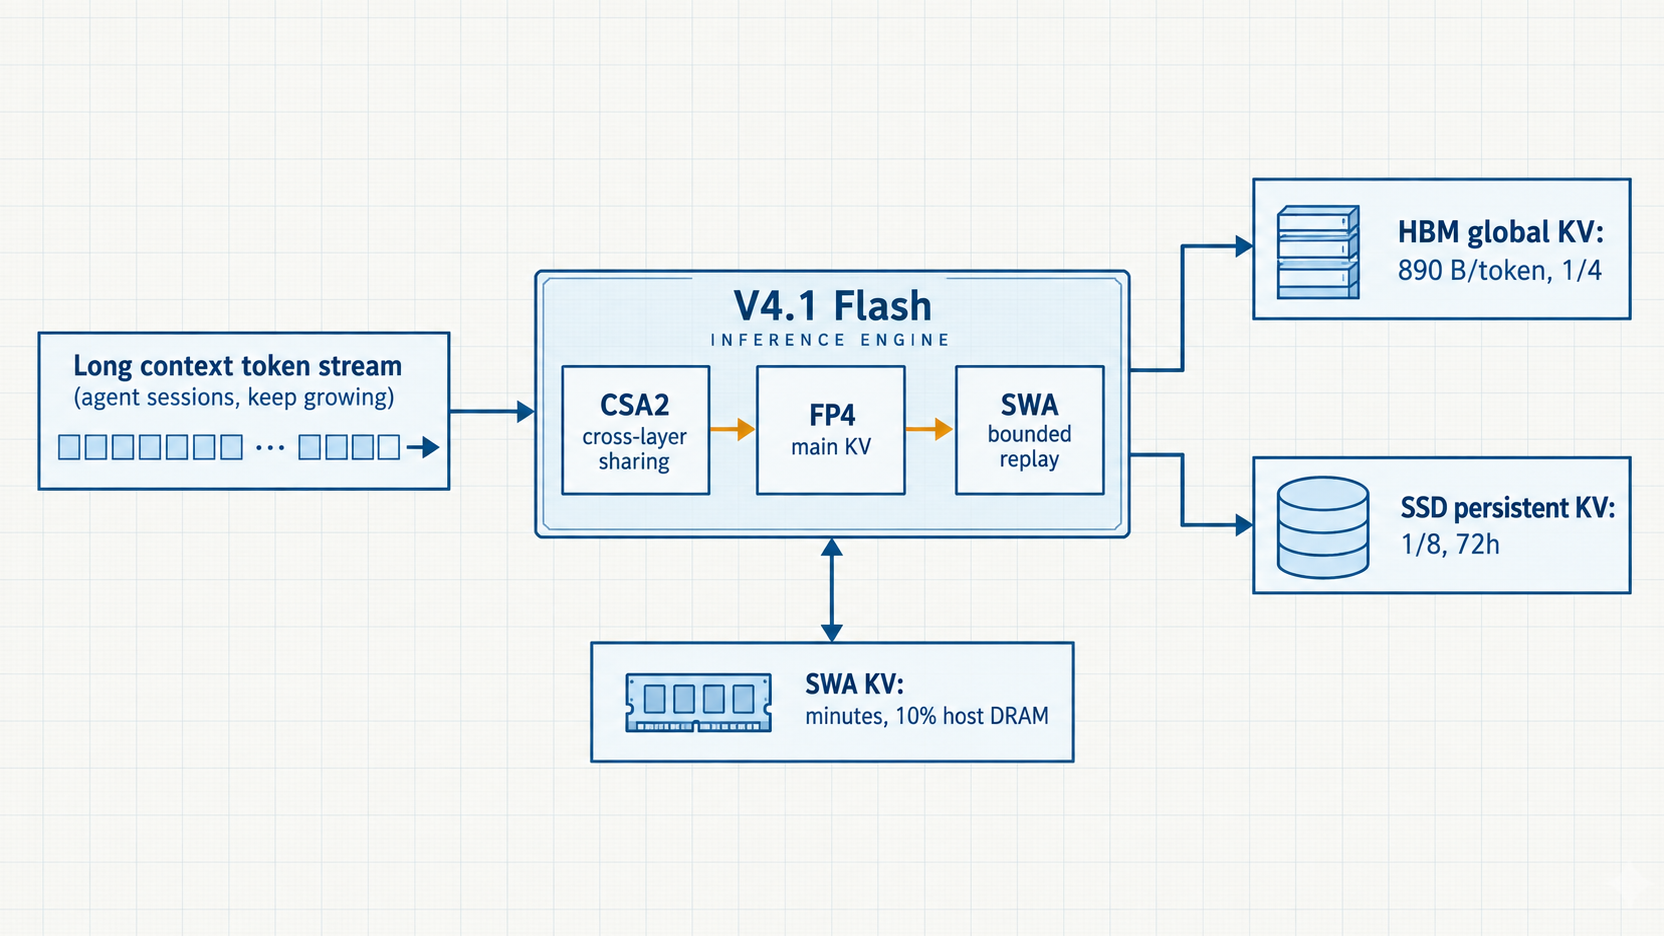
DeepSeek V4.1 Flash 是原生支援 100 萬 token 上下文的多模態模型。根據機器之心對其技術報告的解讀,這個版本把常駐 GPU 高頻寬記憶體(HBM)的全域 KV 快取壓到每 token 890 位元組,約為 V4-Flash 的四分之一。供前綴重複使用的持久化 KV 快取,則縮到 V4-Flash 的約八分之一。它如何減少這些資料,又保留後續計算需要的狀態?
要理解這個問題,得先區分計算與快取的成本。來源指出,稀疏注意力已降低長序列的計算負擔,但輸入繁重的代理程式工作仍受儲存與搬移限制。HBM 裝得下多少全域 KV,會限制同時服務的請求數。SSD 與主機記憶體的容量,影響前綴快取能保留多久。即使資料還在,載入速度也受 IO 與互連頻寬限制。
因此,減少快取不只節省空間,也能降低後續請求載入既有狀態的負擔。
CSA2 是這個版本用來壓縮 KV 快取的稀疏注意力設計。報告把壓縮分成條目大小、序列長度與層數三個維度。單筆條目可以縮小,多個 token 可以合成一筆,部分層也可以沿用其他層的資料。這些維度的壓縮效果能相乘,而 CSA2 同時利用了這些空間。
跨層共用的問題是,每層是否還能選擇自己需要的內容?CSA2 為各層預先指定不同模式,決定哪些資料自己計算、哪些沿用。Full 模式自行產生主要 KV,也執行完整索引流程,選出注意力要讀取的 Top-K 項目,也就是評分最高的 K 個項目。
Reindex 模式沿用前面某層的主要 KV 與索引器鍵向量,但用自己的索引器查詢向量重新評分。因此,共用同一份快取的層,仍能選出不同項目。Reuse 模式則連 Top-K 索引都沿用,直接執行稀疏注意力,省去重新選擇的計算。
共用也有保留範圍。每層仍有自己的全域查詢向量,以及滑動視窗注意力(SWA)使用的局部 KV。SWA 處理局部範圍的資訊,其 KV 仍由各層自己的隱藏狀態計算。這讓跨層共用不必把每層的注意力計算全部變成相同的操作。
除了減少重複保存的資料,V4.1 Flash 也把主要 KV 快取量化為 FP4,進一步縮小表示資料所需的空間。來源列出的格式是 E2M1,每 16 個通道搭配一個 E4M3 縮放因子。相較於 V4 已用在索引器查詢與鍵向量上的 FP4,這次量化的範圍擴及主要 KV。
不過,即使全域快取縮小,局部 KV 仍可能占用大量持久化空間。報告指出,在 V4 的部署中,SWA KV 占持久化快取將近一半。但兩者需要保留的時間不同:全域 KV 可能在很久之後再次被使用,局部 KV 的用途則集中在活躍工作階段內、以分鐘計算的時間範圍。
V4.1 Flash 因此把 SWA KV 移出持久化快取,改放進分散式記憶體池。每台機器提供 10% 的主機 DRAM,資料存活時間只有幾分鐘,靠快速周轉服務絕大多數並行工作階段。全域 KV 則繼續保存在 SSD,生命週期至少 72 小時。
這樣會遇到一種情況:全域 KV 還在,對應的局部 KV 卻已過期。若要精確重建局部狀態,滑動視窗的相依範圍會隨層數累積,需要重新處理的 token 也跟著增加。來源指出,先前提出的不保存 SWA 快取方案,在正式部署中的重建成本過高。
這次的處理方式接受近似結果。系統只重新處理最近 128 個 token,並把 SWA 的範圍限制在這段序列內。這項做法稱為 Bounded Replay。它不會精確還原完整的局部狀態,但讓局部快取未命中時,只需重算有限長度的輸入。
因此,報告中的快取縮減來自不同機制的配合。CSA2 減少跨層重複保存,FP4 縮小主要 KV 的表示,而局部狀態能以有限重算近似重建,才使 SWA KV 得以退出長期保存。對開頭那種反覆處理長輸入的代理程式而言,這些設計共同減少了必須常駐、長留與搬移的資料,也解釋了全域快取約四分之一、持久化快取約八分之一的結果。
來源:機器之心原文。