代理程式若需要長時間執行並處理大量上下文,模型的運算量與快取占用就會影響執行成本。DeepSeek V4.1 Flash 是支援文字與圖片輸入的開放權重模型,上下文長度可達 100 萬 Token。在 Artificial Analysis 的 Intelligence Index 評測中,它平均每項任務使用的 Token 比 V4 Pro 0813 多,估計費用卻更低。這款模型如何減輕推論負擔,又為何能在用量較高時維持低任務成本?
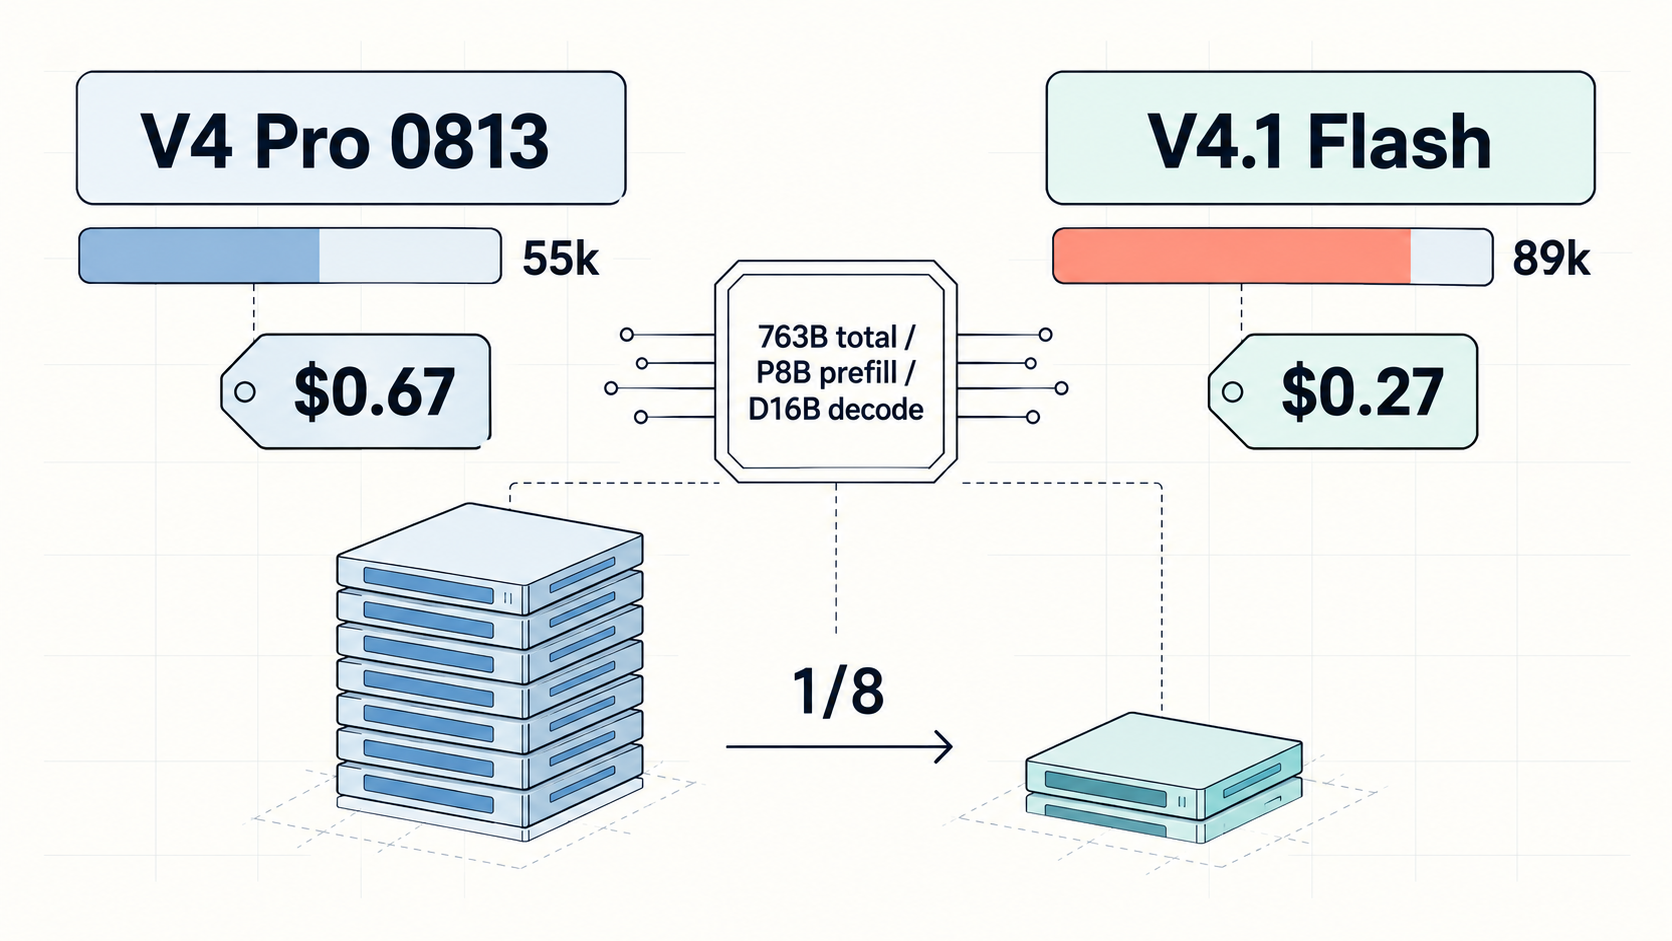
依 Latent Space 的整理,Artificial Analysis 列出的模型總參數量為 763B,B 代表十億。它採用混合專家(MoE)設計,執行時只啟用部分參數。這次的因果編碼器與解碼器架構,進一步把處理輸入與產生輸出的工作分開配置。
處理輸入 Token 的階段叫預填,這時啟用 8B 參數。產生輸出 Token 的階段叫解碼,啟用參數量則是 16B。Latent Space 因此用「763B-P8B-D16B」概括模型的總規模,以及兩個階段的啟用量。實際參與運算的參數約占總量的 1% 到 2%,而且輸入與輸出的配置不同,不能直接拿 763B 當作每個 Token 都會用到的運算規模。
除了啟用多少參數,處理長上下文也要考慮快取空間。KV 快取保存模型處理上下文時使用的注意力資料,會占用記憶體或儲存空間。技術解讀者 Stochastic Chasm 將這次的注意力設計概括為兩個分支,一個在局部滑動視窗內處理注意力,另一個負責稀疏檢索。
Latent Space 轉述技術報告指出,這套架構搭配滑動視窗注意力等調整,KV 快取占用最多可縮到 V4 Flash 的八分之一。來源彙整的 DeepSeek 主張也區分了儲存位置:相較前一代,高頻寬記憶體(HBM)上的 KV 快取需求降為四分之一,SSD 上的快取儲存需求降為八分之一。
技術解讀者 Nrehiew 也引用了評測配置下的數字,KV 大小約為每 Token 890 位元組。他認為,KV 快取壓縮是這套模型追求推論效率的核心。對需要長時間運作的代理程式,Latent Space 也把較小的快取占用視為改善速度與成本的原因。
這些架構設計處理的是運算與儲存負擔。使用 API 時,任務費用還要看 Token 單價與實際用量。Artificial Analysis 列出的價格是每百萬輸入 Token 0.30 美元,每百萬輸出 Token 1.20 美元。快取輸入另以每百萬 Token 0.006 美元計價,離峰時段還有額外 50% 折扣。
低價之下的能力表現,可以先看同一家機構的 Intelligence Index。DeepSeek V4.1 Flash 得到 40 分,高於 V4 Pro 0813,但略低於 GLM-5.3-Flash。也就是說,它在這項綜合評測超過前代 Pro,仍有其他開放權重模型得分更高。
代價則出現在 Token 用量。Artificial Analysis 表示,這是他們測過輸出最冗長的模型之一,平均每項 Intelligence Index 任務使用 8.9 萬 Token。V4 Pro 0813 的平均值是 5.5 萬,前者多了約 62%。即使用量增加,該機構估計新模型每項任務只需 0.27 美元,V4 Pro 0813 則是 0.67 美元。這組結果顯示,較低的 Token 定價讓模型即使用量增加,估計任務費用仍約為前代的四成。
另一家機構 Vals 在自家的 Vals Index 評測中,將它列為開放權重模型第一名,領先 Kimi K3,每次測試花費 0.30 美元,也是該類前十名中最便宜的模型。這次測試採用 100 萬 Token 上下文,最大輸出設為 384 Token,temperature 為 1,top-p 與 top-k 維持預設,推理投入程度設為高。這筆費用屬於 Vals 的測試條件,與前面的 Intelligence Index 每項任務費用分屬不同評測。
回到開頭的問題,DeepSeek V4.1 Flash 在架構上分別配置預填與解碼的啟用參數,並壓縮處理上下文所需的 KV 快取。至於使用者付出的任務費用,Artificial Analysis 的結果給出了具體答案:在它的評測與成本估算中,低單價抵銷了較長輸出帶來的額外費用,讓模型在分數高於 V4 Pro 0813 的同時,維持更低的估計任務成本。